Smart Dashboard
Adjunte un dataset, pida un dashboard y obtenga uno consistente y validado. Alisio lo planifica, consulta y dibuja con reglas fijas, así que el modelo no escribe código para ello.
Qué le aporta
Construir un dashboard a mano obliga al modelo a decidir de una sola vez qué analizar, qué consultar, qué gráfico encaja, cómo maquetar y cómo escribir el script. Eso cuesta tiempo y tokens, y el resultado varía de una ejecución a otra. La herramienta dashboard_generate recibe solo su intención (el dataset y, opcionalmente, un objetivo) y construye el dashboard con código determinista:
- Sin código generado. Nada que leer, aprobar ni depurar: el modelo llama a una sola herramienta.
- Consistente. El mismo dataset y el mismo objetivo dan el mismo dashboard, con títulos, etiquetas y formatos numéricos legibles.
- Validado. El plan se comprueba contra las columnas del dataset antes de consultar nada, así que un gráfico nunca apunta a una columna que no existe.
- Funciona sin conexión y sin proveedor de decisiones. Todo se ejecuta dentro de Alisio.
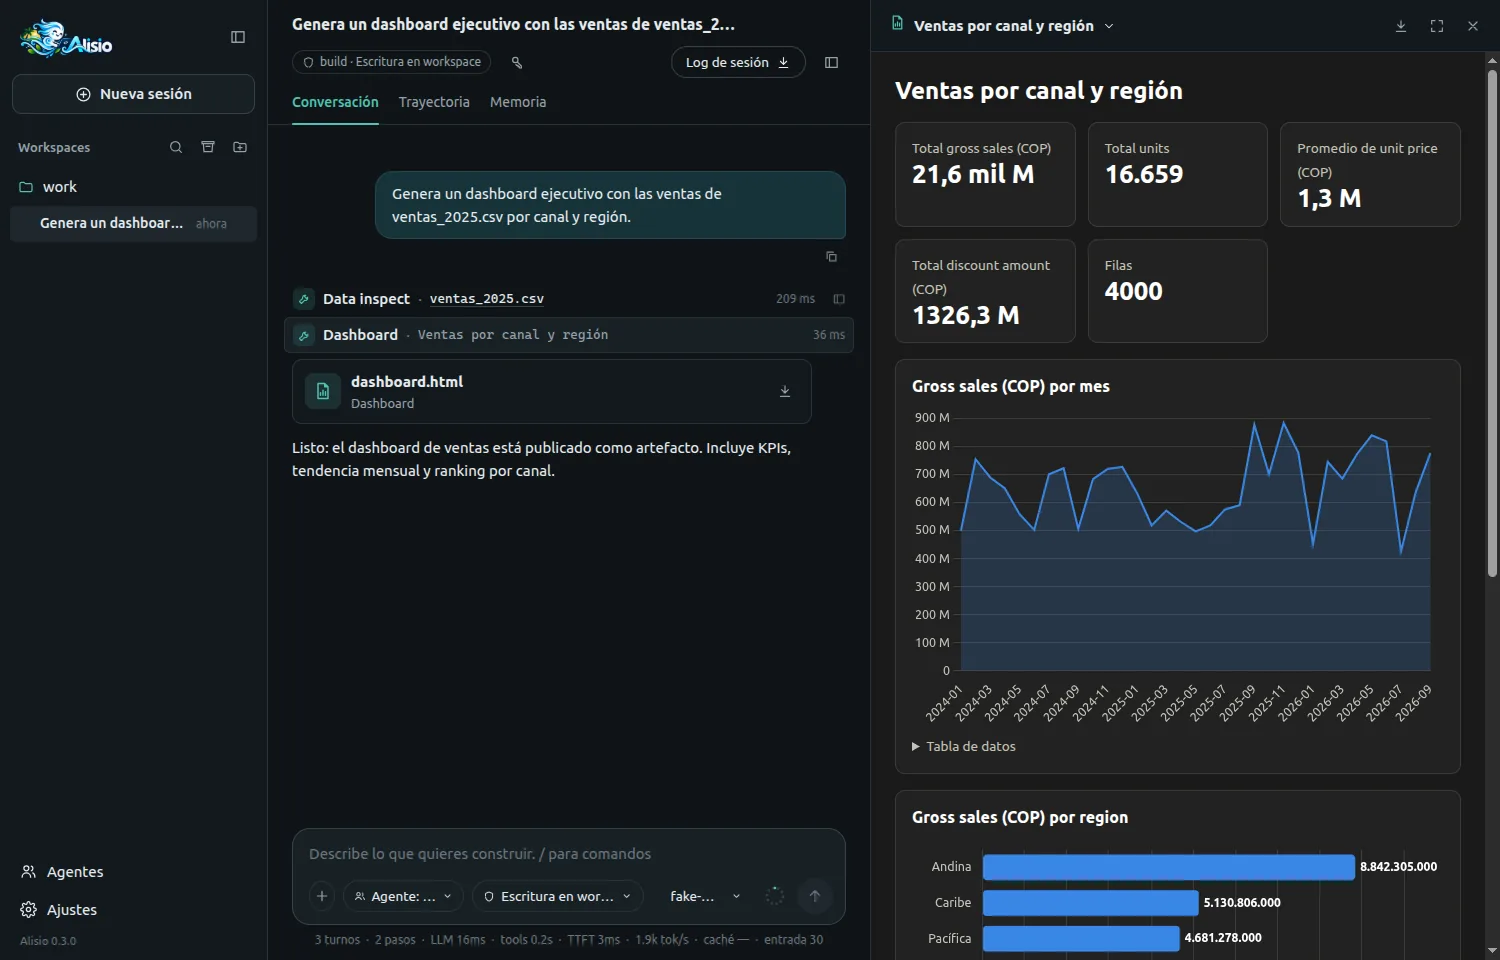
dashboard_generate a partir de un CSV de ventas, abierto en el visor aislado.Cómo usarlo
Pídalo en lenguaje natural, con un archivo del workspace o uno adjuntado en la interfaz web:
Generate an executive dashboard with the sales of sales_2025.csv by channel and regionAlisio ingiere el archivo como dataset (consulte Datos tabulares) y el modelo llama a dashboard_generate { datasetId }. El dashboard se publica como un artefacto llamado dashboard.html; el resultado enumera sus componentes. La herramienta recibe estas entradas:
| Entrada | Obligatoria | Significado |
|---|---|---|
datasetId | sí | Un dataset de esta sesión. |
goal | no | Para qué sirve el dashboard, hasta 2000 caracteres (un texto más largo se recorta, con una nota). Nombre las columnas que quiere ver. |
title | no | El título del dashboard, hasta 120 caracteres. |
locale | no | en (por defecto) o es: el idioma de los títulos y etiquetas generados. |
sheet | no | Una hoja de una hoja de cálculo (XLSX), por nombre; la primera por defecto. |
Para regenerarlo, pídalo de nuevo con otro objetivo (por ejemplo «ahora una vista operativa»). Cada llamada es independiente: no edita el dashboard anterior, y las mismas entradas sobre los mismos datos dan el mismo resultado. El objetivo elige el propósito por las palabras que reconoce: un resumen o vista ejecutiva (el valor por defecto) empieza por KPI, una tendencia y rankings; un objetivo de monitoreo o estado pone primero la tabla de detalle y los rankings; un objetivo de análisis o comparación añade un gráfico de correlación y la tabla. El objetivo también elige las columnas. El planificador lo compara con los nombres y las cabeceras de sus columnas (palabras completas, sin distinguir mayúsculas ni acentos, singular o plural, con sinónimos simples en inglés y español como seller y vendedor) y planifica para lo que encuentra: una medida que usted nombra pasa a ser un KPI y encabeza los gráficos, y cada dimensión que nombra recibe su propio gráfico, en el orden en que la escribió y antes de los gráficos por defecto. Un dashboard tiene como máximo 12 componentes, así que si nombra más de los que caben, los últimos se dejan fuera y aparecen en el resultado como «No mostradas». Los identificadores (como el id de un pedido) nunca se grafican. Los nombres de columna de sus datos se conservan tal cual; solo los títulos generados siguen locale.
Qué construye
| Componente | Se usa para |
|---|---|
| KPI | Una cifra destacada: suma, promedio, mínimo, máximo, conteo o conteo de distintos. |
| Línea, área | Una medida a lo largo del tiempo. |
| Barras, barras horizontales | Un ranking de las categorías de una columna. |
| Tarta, anillo | La participación de cada categoría en el total. |
| Dispersión | La relación entre dos medidas. |
| Tabla | Filas de detalle. |
Unos límites mantienen la página legible: como máximo 12 componentes, 6 KPI y 8 columnas de tabla, y de 1 a 20 categorías en un ranking (10 por defecto). Antes de planificar, Alisio perfila cada columna y elige listas cortas de hasta 8 medidas, 8 dimensiones y 4 columnas de tiempo. Detalles con los que puede contar:
- Los KPI usan números compactos. A partir de un millón una tarjeta muestra
21.6B(o21,6 mil Mcon el idioma español) para que nunca se recorte, y el valor exacto queda en la ayuda emergente de la tarjeta. Los porcentajes nunca se compactan, y la moneda nunca se infiere de los datos: un número se muestra como número. - Nombres de columna legibles. Un encabezado como
gross_sales_coppasa a «Gross sales (COP)»; un encabezado que ya se lee como texto se conserva. - Cubos de tiempo. Una tendencia agrupa por días, semanas, meses, trimestres o años según el rango de los datos. Elige la agrupación más gruesa que deje el gráfico por debajo de 400 puntos en lugar de cortar el final. Solo las fechas ISO 8601 se tratan como columnas de tiempo, y las marcas con zona horaria se leen en UTC.
- Top N y «Otros». Un ranking muestra las categorías principales e indica cuándo hay más. Un gráfico de participación agrupa el resto en una porción «Otros»; una tarta o anillo con más de 6 porciones pasa a ser una barra horizontal.
- Notas en lugar de fallos. Si un componente no se puede construir (por ejemplo, su consulta es demasiado lenta), los demás se publican igualmente y el resultado anota lo que se dejó fuera. Si no se puede construir ninguno, la herramienta falla con un error claro y no publica nada.
Cómo decide
Primero las reglas. Un planificador basado en reglas calcula siempre un plan completo: clasifica las columnas (tiempo, medida, dimensión, identificador, booleano), elige la medida principal y los gráficos a partir de las columnas que nombra el objetivo y de los nombres de columna, y escoge los componentes. Luego el plan se valida y se repara de forma determinista (una línea sobre una columna que no es de tiempo pasa a barras, una columna desconocida se descarta, los límites se acotan). Nunca se llama al modelo para repararlo.
Un proveedor de decisiones opcional refina una única elección cerrada sobre las reglas: el propósito del dashboard (ejecutivo, operativo o analítico). Todo lo demás (la medida principal, las dimensiones de ranking y composición y si se incluyen la tendencia, el ranking, la composición y la dispersión) lo deciden siempre las reglas. Está medido, no supuesto: con 375 decisiones etiquetadas y el Laya 0.3.24 real (cerca de la mitad en español) el propósito acertó el 90 %, mientras que las elecciones de columna y de incluir o no un gráfico quedaron cerca del azar, y cada pregunta adicional hace más lenta la respuesta en CPU. La respuesta sustituye a su valor de la regla solo cuando el proveedor la responde. Sin proveedor el dashboard es igual de válido y reproducible. Es la primera función que usa decisiones; consulte Decision Intelligence para saber cómo se instala y se activa un proveedor.
Qué se envía a un proveedor: solo su objetivo (truncado a 500 caracteres) y, por cada columna preseleccionada, un ID corto y opaco, su etiqueta, su rol, su tipo inferido y un cubo de cardinalidad (binaria, baja, media, alta o muy alta). Nunca se envían valores de celdas, valores frecuentes, mínimos, máximos ni muestras. Consulte Privacidad.
Seguridad
- El modelo no escribe código. El planificador y el renderizador son código propio de Alisio; ni el modelo ni un proveedor pueden inyectar HTML, JavaScript, Python o SQL.
- El SQL sale solo de sus columnas. Cada componente es un
SELECTconstruido con los nombres de columna del propio dataset, siempre entrecomillados, sin texto del modelo ni de un proveedor. Se ejecuta por el mismo motor de datasets de solo lectura quedata_query, con su tiempo límite. - El texto se escapa. Los títulos y las etiquetas se limpian y se escapan antes de llegar a la página.
- Sin red ni CDN. Chart.js se incrusta una sola vez, así que el dashboard funciona sin conexión, en el visor aislado y en el archivo descargado.
- Huella pequeña. La herramienta lee un dataset de la sesión y escribe un artefacto en el almacén de artefactos de Alisio: ningún proceso, ninguna red y ningún archivo del workspace. Tiene el efecto
internal, así que no pide aprobación, igual queartifact_create.
Progreso
Mientras trabaja, la herramienta informa de pasos cortos: Analyzing dataset…, Planning dashboard…, Building N components…, Query i/N… y Dashboard ready. La interfaz web muestra la última línea en la fila de la herramienta en curso. La terminal muestra la última línea junto al resumen de la herramienta y la borra cuando esta termina.
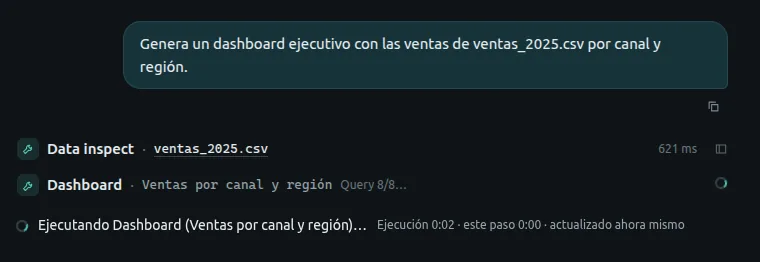
dashboard_generate en curso, con la última línea de progreso.Cuándo usar python_run en su lugar
El catálogo cubre el dashboard habitual. Para cualquier otra cosa, como pruebas estadísticas, gráficos personalizados o no admitidos, uniones entre hojas o archivos, o exportaciones, el modelo usa python_run con alisio_runtime.charts. Cuando no se puede planificar ningún dashboard (el dataset no tiene una columna de medida, dimensión o tiempo utilizable), la herramienta lo dice y remite a python_run.
El interruptor
analysis.smartDashboard (por defecto true) controla la herramienta y la guía que orienta al modelo hacia ella. Con false, dashboard_generate no se registra (no aparece en /tools) y la guía al modelo vuelve al flujo de Python.
Con true, las descripciones que lee el modelo orientan una petición de dashboard sobre un dataset hacia dashboard_generate (sin código) y reservan python_run para lo que el catálogo no cubre: análisis estadístico, gráficos personalizados o no admitidos, uniones y exportaciones. Con false esos textos son exactamente los de 0.3.0.
{ "analysis": { "smartDashboard": false } }Sigue las capas de configuración habituales, con una regla que conviene conocer: un false global no puede deshacerlo un proyecto, mientras que un proyecto sí puede apagarlo para sí mismo. Puede cambiarlo desde Ajustes → Análisis de datos en la interfaz web o con /settings en la terminal; se aplica la próxima vez que se inicie Alisio. También requiere analysis.enabled.
Limitaciones
- No está disponible con
--read-only. La herramienta publica un artefacto, así que se elimina igual queartifact_create. Sin ella, las herramientas de datos siguen funcionando. - Un dataset por llamada y sin uniones. Cada llamada es independiente de los dashboards anteriores.
- Sin filtros interactivos. El dashboard es una composición estática.
- Sin tablas cruzadas. Un gráfico agrupa por una dimensión; un cruce como canal x región no está en el catálogo.
- Sin filtros de filas. No se pueden excluir filas (por ejemplo los pedidos cancelados) de los datos que lee el dashboard.
- Sin métricas derivadas. No se calculan margen, variación interanual ni tasas; solo se miden columnas que existen en el dataset.
Para cualquiera de estos casos el agente usa python_run, después de la herramienta o en su lugar. Para mantenerlo en la herramienta, pida columnas o medidas exactas que existan (por ejemplo «ventas netas», si el dataset tiene esa columna). Si necesita un filtro o un cruce, dígalo en el prompt: así el agente sabe que debe pasar a Python.
- Solo las fechas ISO 8601 son columnas de tiempo; otros formatos de fecha no dan tendencia. Las horas con zona se muestran en UTC.
- Sin moneda. El dinero se muestra como número; el nombre de la columna (por ejemplo
COP) se conserva en la etiqueta.
Una ejecución real con Laya
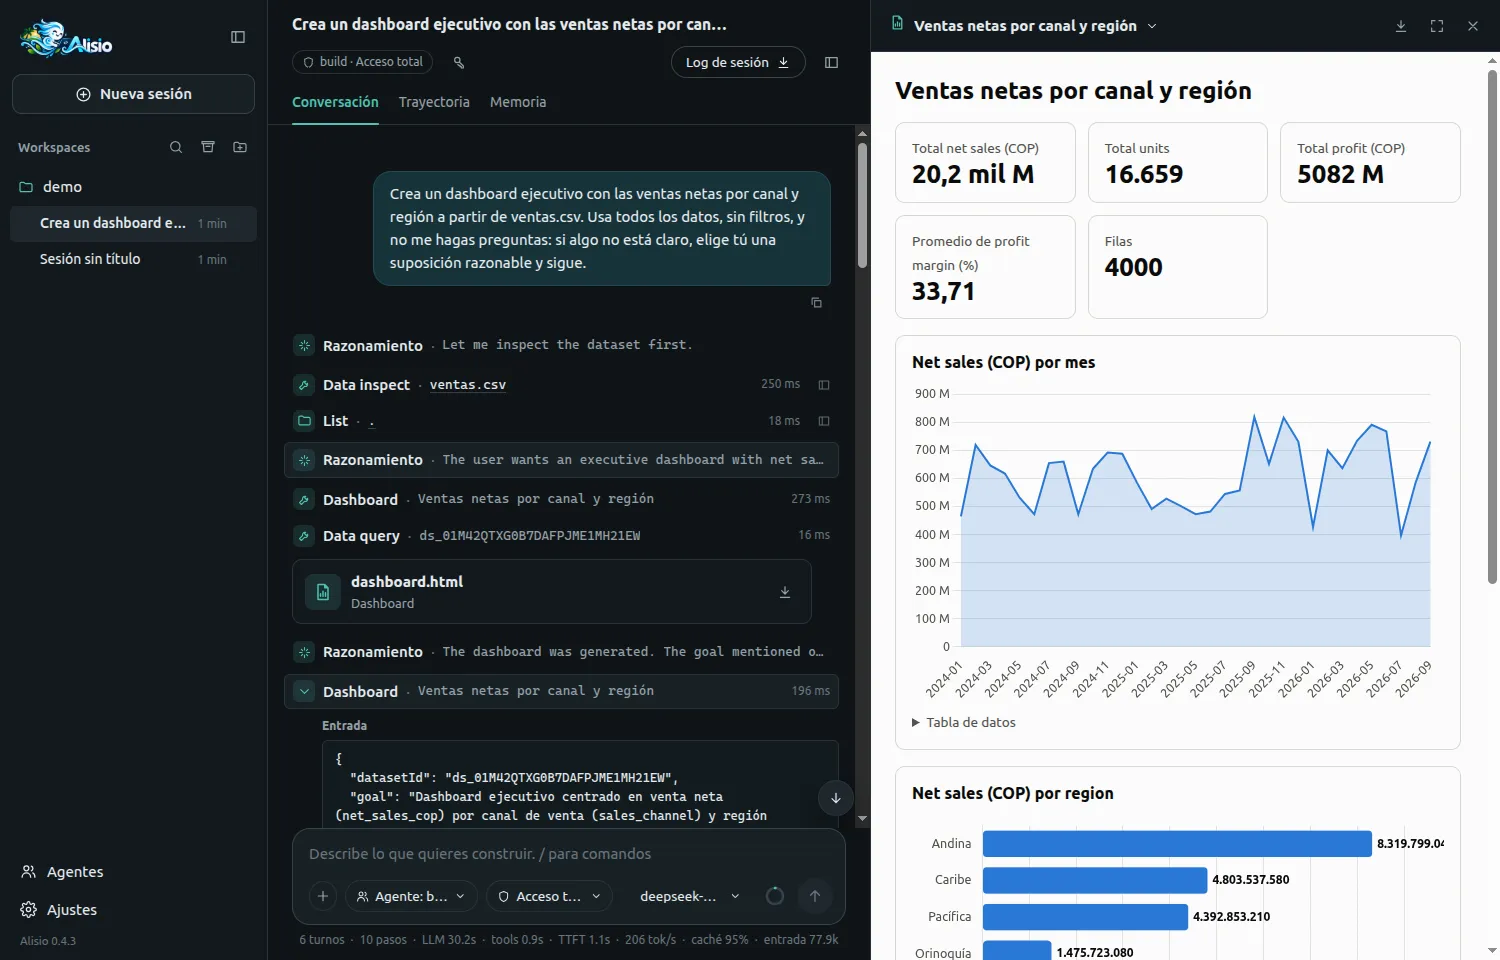
Son dos sesiones reales (2026-10-04) en la interfaz web, con la compilación candidata de 0.4.3, @alisio/plugin-laya 0.1.1 y deepseek-flash como modelo. El dataset es un CSV de ventas de 4000 filas renombrado ventas.csv. Ambas ejecuciones usaron el mismo prompt en español, «Crea un dashboard ejecutivo con las ventas netas por canal y región a partir de ventas.csv. Usa todos los datos, sin filtros, y no me hagas preguntas…», y el modo de permisos «Acceso total», así que el agente no hizo preguntas ni mostró solicitudes de aprobación, y nadie esperó al usuario. Una ejecución tuvo Laya activo (L) y la otra no tuvo proveedor de decisiones y la memoria desactivada (N2).
| Medida | Con Laya (L) | Sin proveedor, memoria desactivada (N2) |
|---|---|---|
| Del envío al primer dashboard publicado | 5,0 s | 4,5 s |
La llamada a dashboard_generate en sí | 161 ms | 52 ms |
| Tiempo del modelo antes de llamar a la herramienta | 4,9 s (2 turnos) | 4,5 s (1+ turnos) |
| Decisiones | 2 completadas (101 ms y 30 ms, confianza 0,99 o más, ninguna rechazada, sin fallback) | ninguna |
| Procedencia del artefacto | rules+decisions, proveedor de decisiones laya | rules |
| Medida principal y gráficos | las ventas netas lideran en ambas; KPI ventas netas, unidades, utilidad, margen, filas; ventas netas en el tiempo, por región, por canal | igual |
python_run después del dashboard | 0 | 4 llamadas y 1 dashboard extra en Python («Complemento ejecutivo: canal × región») 35,7 s después |
| Dashboards publicados | 2, ambos de dashboard_generate (el modelo llamó a la herramienta una segunda vez, 5,7 s después) | 2 (1 generado + 1 de Python) |
| Ejecución completa (turnos / llamadas a herramientas / tokens de entrada + salida) | 32,3 s (6 / 10 / 77.919 + 6.223) | 45,2 s (8 / 7 / 111.240 + 9.424) |
Tras la ejecución con Laya, /decisions informó 2 peticiones, 2 completadas, 0 fallbacks, latencia media de 66 ms y percentil 95 de 101 ms (véase Decision Intelligence).
Qué esperar:
- El tiempo hasta un dashboard fue de unos 5 s en ambas ejecuciones. La herramienta más la respuesta de Laya tardaron bastante menos de un cuarto de segundo; Laya añade unos 100 ms a la llamada de la herramienta.
- En la ejecución con Laya el modelo no reconstruyó nada en Python. Sin proveedor sí lo hizo, pero una ejecución por configuración no puede demostrar que Laya sea la causa.
- El dashboard tiene gráficos por canal y por región, pero no una tabla cruzada canal x región (no está en el catálogo). Cuando la petición la necesita, el agente recurre a Python. Véanse las Limitaciones.
- Las notas de memoria de sesiones anteriores pueden cambiar lo que hace el agente. Hubo que descartar una tercera ejecución (memoria activada, sin proveedor) porque una nota guardada por una ejecución anterior orientó al agente.
Es una sesión por configuración, un dataset y un modelo; no demuestra una diferencia estadística ni es un benchmark. Para la comparación medida véanse los Resultados del benchmark.
A modo de comparación, la primera ejecución, con la 0.4.2 publicada, hizo dos preguntas al usuario. Tardó 672 s del envío al dashboard, y 607 s fueron el agente esperando las respuestas del usuario. Además, el modelo reconstruyó el dashboard en Python porque «ventas netas» no coincidía con la columna de ventas netas; está corregido en esta versión.
Resultados del benchmark
El benchmark que compara esta herramienta con el flujo de Python se ejecuta a mano con scripts/bench-dashboard.ts, y sus resultados (con todas las ejecuciones) se publican en docs/benchmark-dashboard.json. Las tres variantes usaron deepseek-flash (api.deepseek.com), un prompt en inglés y Alisio 0.3.0 con el código de Smart Dashboard aún sin publicar: A es el flujo de Python sin la herramienta (45 ejecuciones, 15 datasets x 3), B tiene dashboard_generate (15 ejecuciones, 15 datasets x 1 repetición) y C es B más el proveedor de decisiones Laya (5 ejecuciones, solo datasets pequeños, informativa). B y C se ejecutaron en paralelo, así que el tiempo hasta el artefacto no es comparable entre variantes.
| Mediana por ejecución | A (Python) | B (herramienta) | C (herramienta + Laya) |
|---|---|---|---|
| Ejecuciones | 45 | 15 | 5 |
| Tokens de salida | 46 281 | 33 098 | 28 904 |
| Tokens de entrada (en caché) | 672 393 (643 072) | 502 399 (491 904) | 395 118 (383 744) |
| Turnos | 23 | 21 | 17 |
| Llamadas a herramientas | 30 | 29 | 22 |
| Tiempo hasta el artefacto | 158,7 s | 12,9 s | 9,7 s |
Ejecuciones que llamaron a dashboard_generate | n/a | 15 / 15 | 5 / 5 |
DashboardSpec válidos | n/a | 15 / 15 | 5 / 5 |
| Avisos de chart-lint | 0 | 0 | 0 |
| Clases de fallo | 25 ejecuciones sin cierre limpio | 3 por presupuesto de tokens | ninguna |
- Puerta (especificación 11.2), B frente a A: no se cumple. Los tokens de salida bajaron un 28,5 % (objetivo 50 %) y los turnos un 8,7 % (objetivo 40 %); los specs fueron 100 % válidos y no hubo avisos de lint. El modelo sigue llamando a
python_rundespués dedashboard_generateen casi todas las ejecuciones (15 / 15 de B lo usaron; en C, 4 de 5), lo que explica el ahorro pequeño. - Las ejecuciones de A se cortan por el presupuesto de 1 000 000 de tokens por ejecución (
Token budget exhausted), así que sus tokens y turnos son un límite inferior y la comparación es conservadora frente a B. El mismo presupuesto detuvo 3 ejecuciones de B después de publicar un dashboard. - C: Laya respondió en 4 de 5 ejecuciones (
rules+decisions); una cayó a reglas (todas las respuestas rechazadas). La latencia de decisión fue de 271-561 ms. Un Laya en frío respondenot_readyy se recurre a las reglas durante sus primeros segundos, como pasó en una ejecución de humo previa. - B usó una repetición por dataset, por lo que sus medianas son menos estables que las de A.